들어가며
"트래픽이 많지 않으니 대충 설계해도 되겠지"라고 생각했다가 몇 명만 몰려도 서버가 뻗어버리는 경험, 서비스를 운영해보신 분이라면 한 번쯤 겪어보셨을 텐데요. 저 역시 그 시행착오를 그대로 겪으면서 지금의 구조를 만들었습니다.
이번 글에서 소개해드릴 내용은 이래요.
- 서버가 왜 "총 방문자 수"가 아니라 "동시성"에서 무너지는지
- 제가 실제 프로젝트(SafePath AI)에서 겪었던 문제와, 캐싱 파이프라인으로 해결한 과정
- 기능 단위로 서버를 나누는 설계 방식
- 예산이 부족한 1인 개발자도 바로 적용할 수 있는 구체적인 방어 전략
순서대로 하나씩 소개해드릴게요.
제 포트폴리오(dev.rederx.com)에서 실제로 운영 중인 프로젝트들을 확인하실 수 있고, 웹 호스팅 자체를 어떻게 구성했는지 궁금하신 분들은 복잡한 네트워크 설정 없이 내 웹서버를 세상에 여는 방법을, 서버가 실제로 다운됐을 때 SEO와 사용자 경험을 지키는 방법이 궁금하신 분들은 웹서버 다운 시 SEO와 사용자 경험 보호 전략을 함께 참고하시면 좋아요.
숫자로 먼저 보여드릴게요
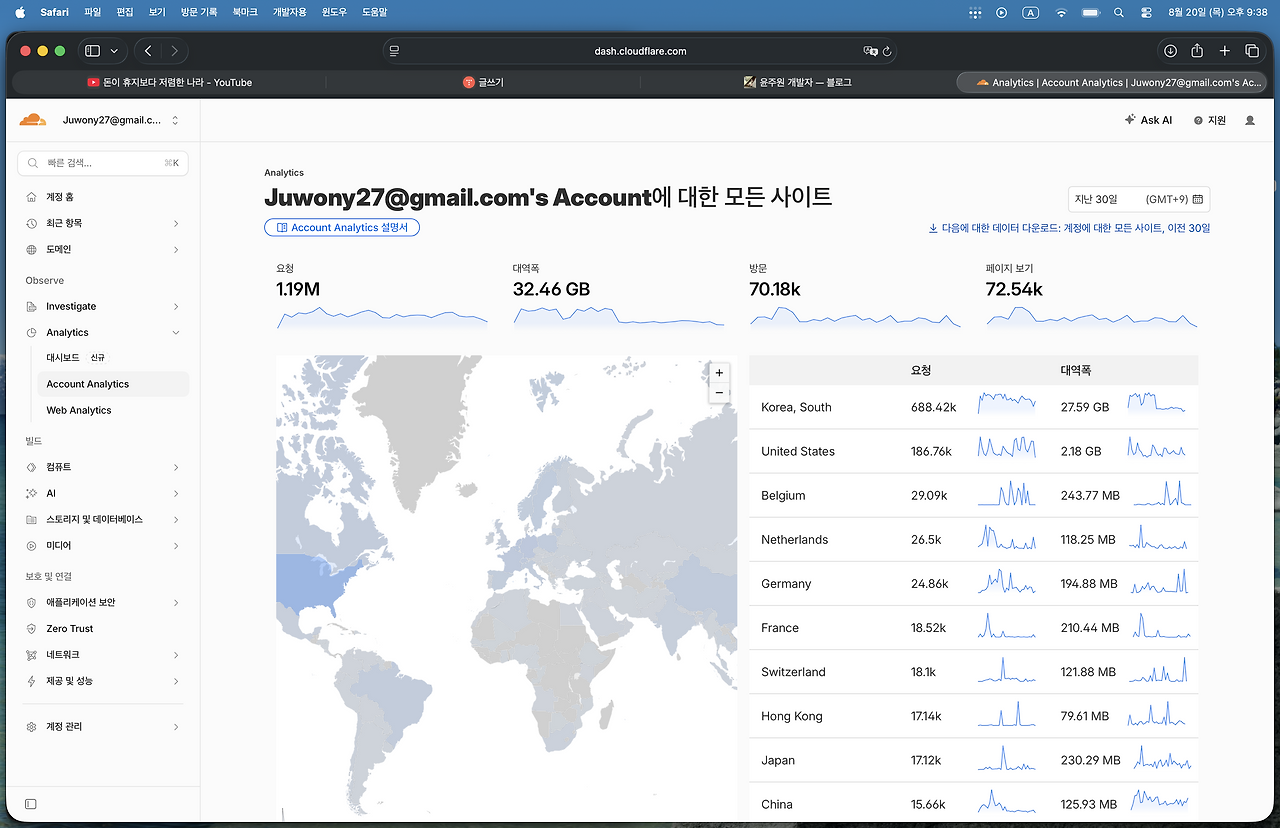
지난 한 달 기준으로 Cloudflare Analytics에 찍힌 수치예요. 순 방문자는 약 7만 명, 요청 수는 100만 건을 넘겼는데, 이걸 전부 서버 단 1대로 처리했습니다. 서버 사양 자체는 화려하지 않아요. 결국 하드웨어 스펙보다 "구조를 어떻게 짰는가"가 훨씬 크게 작용한다는 걸 직접 겪으면서 알게 됐어요.
트래픽보다 무서운 건 "동시성"이에요
서버를 여러 번 설계해보면서 제가 가장 중요하게 생각하게 된 기준이 하나 있어요.
"월 평균 방문자가 적더라도, 어느 순간 몇백 명이 동시에 몰릴 수 있다"는 전제로 설계해야 한다.
이게 왜 중요하냐면, 서버가 죽는 결정적인 원인은 대부분 "총 방문자 수"가 아니라 동일 시점에 몰리는 동시 요청이기 때문이에요. 예를 들어 한 달에 7만 명이 방문한다고 해도, 이 방문자들이 30일 동안 고르게 분산돼서 들어온다면 서버 입장에서는 사실 별로 부담스럽지 않아요. 문제는 특정 순간(SNS에 글이 퍼지는 순간, 뉴스에 소개되는 순간 등)에 수백 명이 동시에 들어오는 경우예요.
이때 벌어지는 일을 순서대로 보면 이렇습니다.
- 동시 요청이 몰리면서 서버의 CPU·메모리 연산량이 순간적으로 급증해요.
- 처리 속도가 요청이 들어오는 속도를 따라가지 못하면서, 아직 처리되지 못한 요청들이 대기열에 쌓이기 시작해요.
- 응답이 늦어지니 사용자는 "왜 안 되지?"하며 새로고침을 누르거나 재요청을 보내요.
- 이 재요청이 다시 대기열에 더해지면서 서버 부하는 더 빠르게 늘어나요.
- 결국 메모리가 가득 차거나 프로세스가 응답 자체를 못 하는 상태에 빠지면서 서버가 다운돼요.
저는 이걸 "눈덩이 효과"라고 부르는데요, 한 번 지연이 시작되면 사용자의 재요청이 오히려 부하를 가속시키는 악순환이 생기는 거예요. 그래서 서버가 터지는 걸 막으려면 애초에 같은 연산을 반복하지 않도록 만드는 것, 즉 "서버 캐싱 파이프라인"을 얼마나 잘 구축하느냐가 핵심입니다.
사례로 보여드릴게요: SafePath AI
이해를 돕기 위해 제가 직접 만든 프로젝트 하나를 예시로 들어볼게요.
SafePath AI는 CCTV, 가로등, 여성안심귀갓길 같은 안전 구조물 약 200만 개의 위치 데이터를 실시간으로 불러와서 밀집도를 계산한 뒤, 지도의 확대 레벨(zoom level)에 따라 색깔 히트맵으로 렌더링해주는 서비스예요.
프로젝트 코드는 여기서 확인하실 수 있어요 → GitHub: anion15/SafePath-AI
처음엔 2~10명만 들어와도 뻗었어요
이 프로젝트는 트래픽 자체가 문제가 아니었어요. 문제는 연산 비용이었습니다. 사용자가 지도를 옮기거나 확대·축소를 할 때마다, 서버는 그 범위 안에 있는 안전 구조물 데이터를 다시 긁어와서 밀집도를 재계산하고 히트맵을 새로 그려야 했어요. 이 연산 자체가 꽤 무거웠기 때문에, 동시 사용자가 2~10명만 되어도 서버의 연산 큐가 순식간에 밀리면서 서비스가 멈춰버리는 문제가 있었습니다.
해결책: "이미 계산한 결과는 다시 계산하지 않는다"
그래서 저는 사용자가 이미 한 번 요청해서 서버가 계산을 마친 데이터를 caching 폴더 안에 JSON 형태로 저장해두는 캐시 파이프라인을 설계했어요. 동작 방식을 조금 더 구체적으로 풀어보면 이래요.
- 사용자가 특정 확대 레벨과 지도 범위(bounds)로 히트맵을 요청해요.
- 서버는 먼저 "이 확대 레벨 + 이 범위 조합에 대한 캐시가 있는가?"를 확인해요. (확대 레벨과 좌표 범위를 조합해서 캐시 키로 사용해요.)
- 캐시가 있다면 재계산 없이 바로 저장된 JSON을 내려줘요. 이 경우 응답 속도는 밀집도 계산 없이 파일만 읽으면 되니 훨씬 빨라요.
- 캐시가 없다면 그때만 실제 밀집도 계산을 수행하고, 그 결과를 다음 요청을 위해 캐시로 저장해둬요.
이렇게 하니 서비스 초반에는 캐시가 거의 없어서 렉이 꽤 있었지만, 운영한 지 1주일 정도 지나 사람들이 자주 보는 구역의 캐시가 충분히 쌓이면서 대부분의 요청이 "이미 계산된 결과를 그냥 읽어오는" 수준으로 가벼워졌어요. 체감상 서비스가 완전히 다른 수준으로 빨라진 걸 느꼈습니다.
조금 더 욕심을 낸다면
지금은 파일 기반 JSON 캐시로도 충분히 효과를 봤지만, 서비스가 더 커진다면 아래와 같은 보완도 고려해볼 만해요.
- 캐시 유효기간(TTL) 설정: 안전 구조물 데이터는 자주 바뀌지 않지만, 그래도 일정 주기(예: 하루~일주일)로 캐시를 무효화해서 오래된 데이터가 계속 노출되지 않도록 관리하는 게 좋아요.
- 인기 구역 캐시 예열(warm-up): 서비스 배포 직후나 서버 재시작 직후에도 자주 조회되는 구역의 캐시를 미리 계산해두면, 초반 렉을 아예 없앨 수 있어요.
- Redis 같은 인메모리 캐시로 전환: 파일 기반 캐시는 구현이 간단하지만 캐시 항목이 아주 많아지면 디스크 I/O가 병목이 될 수 있어요. 트래픽이 더 늘어난다면 Redis 같은 인메모리 스토어로 옮기는 것도 좋은 다음 단계예요.
두 번째 방법: 기능 단위로 서버를 나누기
두 번째로 소개해드릴 방법은 서버를 기능 단위로 분리해서 운영하는 방식이에요.
참고로 저는 지금 예산이 부족해서 실제로는 서버 1대로 호스팅하고 있어요. 첫 번째 방식, 즉 캐싱 파이프라인만으로도 한 달에 100만 건 이상의 요청을 거뜬히 처리하고 있고요. 다만 예전에 다른 서비스를 설계할 때 아래 방식을 직접 적용해본 경험이 있어서, 트래픽이 더 커졌을 때를 대비해 함께 소개해드리는 거예요.
보통 규모가 있는 서비스들은 서버 한 대로 모든 연산을 처리하지 않아요. 흔히 로드 밸런싱과 헷갈리기 쉬운데, 사실 개념이 조금 달라요.
| 구분 | 로드 밸런싱 | 기능 단위 서버 분리 |
|---|---|---|
| 나누는 기준 | 동일한 연산을 여러 서버에 "똑같이" 분산 | 서버의 "역할"(DB, 렌더링, 정적 자원 등)에 따라 분리 |
| 서버 구성 | 보통 동일한 스펙의 서버를 여러 대 복제 | 역할마다 다른 하드웨어로 최적화 |
| 목적 | 처리량(throughput) 확장 | 각 기능의 병목 해소 + 보안 격리 |
예를 들어 이렇게 나눌 수 있어요.
- DB 서버: 램 기반 캐싱이 많이 필요하니 다른 서버보다 RAM을 넉넉하게 배정해요.
- 서버사이드 렌더링(SSR)/연산 서버: 빠른 병렬 처리가 중요하니 싱글 CPU보다는 멀티 코어·멀티 프로세서 구성이 유리해요.
- 정적 자원 서버(또는 CDN): 이미지, JS, CSS처럼 자주 안 바뀌는 파일은 아예 우리 서버까지 오지 않고 CDN 엣지에서 처리되도록 넘겨버려요.
물론 이 방식은 서버 여러 대를 운영해야 하니 비용이 늘어나는 건 감수해야 해요. 하지만 트래픽이 어느 정도 커진 뒤에는 "서버 한 대를 더 좋은 걸로 바꾸는 것"보다 "역할별로 나누는 것"이 비용 대비 효율이 더 좋아지는 시점이 반드시 와요.
보안 측면에서도 이점이 있어요
사용자의 모든 요청을 서버 한 대가 처리하는 구조에서는, 취약점 하나가 뚫리면 그 서버가 갖고 있는 모든 민감 데이터(DB 접근 권한 포함)가 그대로 노출될 위험이 있어요. 반면 기능 단위로 서버를 나누고 내부망을 잘 분리해두면, 예를 들어 외부에 노출된 웹 서버가 뚫리더라도 DB 서버까지 곧바로 접근하기는 훨씬 어려워져요. 내부자 소행이 아닌 이상 전체 시스템이 한 번에 뚫리는 상황은 거의 발생하지 않는 거죠. 이건 보안에서 흔히 말하는 "공격 표면(attack surface) 최소화"와 "권한 최소화(least privilege)" 원칙과도 맞닿아 있어요.
애초에 안 터지게 만드는 방어 전략
지금까지 설계 원칙과 실제 사례를 소개해드렸는데요, 이제부터는 1인 개발자도 큰 비용 없이 바로 적용할 수 있는 방어 전략들을 소개해드릴게요. 저 역시 서버 1대라는 제한된 환경에서 아래 방법들을 하나씩 적용하며 안정성을 끌어올렸어요.
1. 요청 자체를 제한하기 (Rate Limiting)
한 사용자(또는 봇)가 짧은 시간에 너무 많은 요청을 보내면, 그것만으로도 서버가 감당해야 할 연산량이 폭증해요. Cloudflare를 쓰고 계신다면 대시보드에서 Rate Limiting Rules를 설정해서 "1분에 특정 IP가 요청할 수 있는 횟수"를 제한할 수 있고, 서버 자체에서도 Nginx의 limit_req 모듈로 비슷한 제한을 걸 수 있어요. 특히 연산 비용이 큰 API 엔드포인트(예: 앞서 소개한 히트맵 계산 API)일수록 이 설정이 필수예요.
2. 무거운 연산은 큐(Queue)로 비동기 처리하기
사용자의 요청을 받자마자 무거운 연산을 그 자리에서 바로 처리하면, 동시 요청이 몰릴 때 서버의 요청 처리 스레드·프로세스가 전부 그 연산에 묶여버려요. Redis 기반의 BullMQ 같은 작업 큐를 두고, 무거운 연산은 백그라운드 워커가 순서대로 처리하도록 분리하면 웹 서버 자체는 계속 가볍게 응답할 수 있어요. 사용자에게는 "처리 중입니다" 상태를 먼저 보여주고, 완료되면 결과를 보여주는 식으로 UX를 설계하면 자연스러워요.
3. 우아하게 성능을 낮추는 것도 방어예요 (Graceful Degradation)
모든 요청을 완벽하게 처리하려고 하다가 서버 전체가 죽는 것보다는, 부하가 심할 때 일부 기능을 의도적으로 단순화해서라도 서비스 자체는 살아있게 만드는 게 나을 때가 많아요. 예를 들어 평소에는 실시간으로 정밀 계산을 하다가, 서버 부하가 임계치를 넘으면 자동으로 "가장 최근 캐시된 결과"를 보여주는 식으로 전환하는 회로 차단기(circuit breaker) 패턴을 적용할 수 있어요.
4. 데이터베이스 커넥션 풀링과 인덱싱
의외로 서버가 죽는 원인 중 상당수는 애플리케이션 서버가 아니라 데이터베이스 쪽에서 시작돼요. 요청마다 새로운 DB 커넥션을 맺고 끊으면 그 자체로 오버헤드가 크기 때문에, 커넥션 풀(connection pool)을 미리 만들어두고 재사용하는 게 기본이에요. 여기에 자주 조회하는 컬럼에 인덱스를 걸어두는 것만으로도 쿼리 속도가 몇 배씩 차이 나는 경우가 많아요.
5. CDN 엣지 캐싱으로 서버까지 오는 요청 자체를 줄이기
Cloudflare 같은 CDN을 쓰고 계시다면, 자주 바뀌지 않는 API 응답이나 정적 자원에 적절한 Cache-Control 헤더를 걸어서 CDN 엣지에서 바로 응답하도록 만들 수 있어요. 이렇게 하면 애초에 우리 서버까지 도달하는 요청 수 자체가 줄어들어요. 서버를 더 빠르게 만드는 것보다, "서버까지 안 오게 만드는 것"이 가장 확실한 방어일 때가 많아요.
6. 기본적인 DDoS·봇 방어도 켜두세요
Cloudflare 무료 플랜만으로도 Bot Fight Mode나, 트래픽이 비정상적으로 몰릴 때 수동으로 켤 수 있는 Under Attack Mode 같은 기능을 쓸 수 있어요. 이런 설정은 몇 번의 클릭만으로 적용되는데도 악의적인 트래픽으로부터의 방어 효과는 꽤 큽니다.
7. 프로세스가 죽어도 스스로 살아나게 하기
아무리 방어를 해도 프로세스가 죽는 상황은 언젠가 생겨요. 이때 중요한 건 "사람이 알아채고 수동으로 재시작"하는 게 아니라 시스템이 스스로 복구하는 거예요. systemd로 서비스를 등록했다면 Restart=always 옵션만 추가해도 프로세스가 죽는 즉시 자동으로 재시작돼요. Node.js 기반이라면 PM2 같은 프로세스 매니저를 쓰는 것도 좋은 선택이에요.
서버가 실제로 다운됐을 때 SEO와 사용자에게 어떤 영향이 가는지, 그리고 그 상황에서 구체적으로 무엇을 해야 하는지는 이전 글에서 훨씬 더 깊게 다룬 적이 있어요. 궁금하신 분들은 웹서버 다운 시 SEO와 사용자 경험 보호 전략을 함께 읽어보시길 추천해요.
마치며
정리하면, 1인 개발자가 서버 한 대로 월 수만 명의 트래픽을 버티는 핵심은 결국 두 가지예요.
- 같은 연산을 반복하지 않는 것 — 캐싱 파이프라인으로 이미 계산한 결과는 다시 계산하지 않기
- 서버까지 오는 부하 자체를 줄이는 것 — Rate Limiting, CDN 엣지 캐싱, 큐 기반 비동기 처리로 서버가 감당해야 할 연산량 자체를 관리하기
화려한 인프라나 큰 비용 없이도, 구조를 어떻게 짜느냐에 따라 서버 한 대로도 꽤 많은 트래픽을 안정적으로 버틸 수 있다는 걸 직접 경험하면서 느꼈어요. 이 글이 비슷한 고민을 하고 계신 1인 개발자분들께 조금이나마 도움이 되었으면 좋겠어요.